"○○ 앱 만들어줘"에 빠진 것
말하지 않은 것은 흔해진다
“할 일 앱 만들어줘”라고 시켜 보면 몇 분 뒤 앱이 하나 나옵니다. 화면 위쪽에는 입력창이 있고 그 아래에는 할 일이 쌓이며, 완료한 일에는 줄이 그어집니다. 카드 모양 상자와 둥근 버튼, 색까지 어딘가 익숙합니다. 같은 프롬프트를 넣은 다른 사람도 거의 같은 앱을 받았을 테니까요.
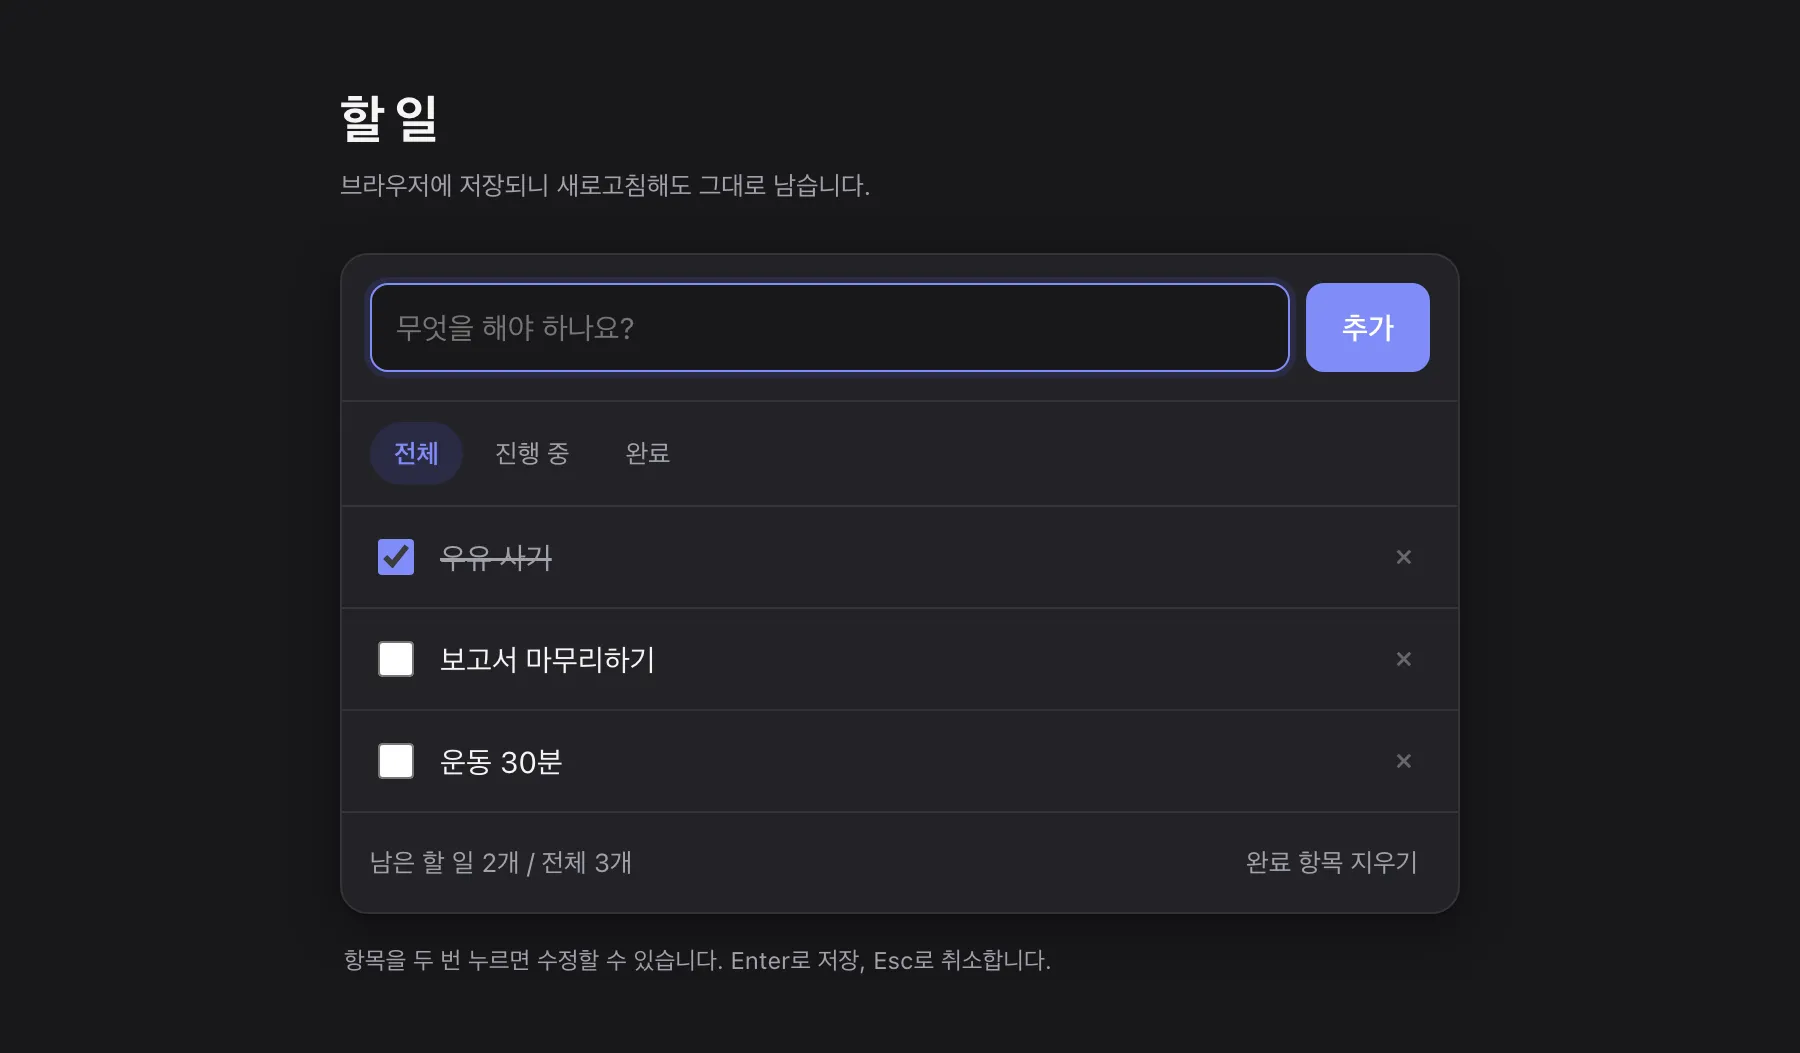
이 결과가 마음에 들지 않으면 AI가 앱을 잘 만들지 못했다고 생각하기 쉽습니다. 하지만 앱은 대체로 잘 돌아갑니다. 문제는 코드가 아니라 제가 말하지 않은 데 있습니다.
앱 하나를 만들려면 수십 가지를 정해야 합니다.
- 누가 쓰는가?
- 휴대폰으로 쓰는가, 컴퓨터로 쓰는가?
- 할 일에 마감일을 둘 것인가?
- 다 한 일은 지우는가, 남기는가?
- 글자는 얼마나 크게 보여 주는가?
“할 일 앱 만들어줘”에는 이 중 어느 것도 들어 있지 않습니다. 그렇다고 AI가 빈자리를 비워 두지는 않습니다. 학습 데이터에 있는 수많은 할 일 앱에서 가장 흔한 답으로 빈자리를 채웁니다. 수십 가지 선택이 모두 그렇게 정해지면 결과도 흔한 앱이 됩니다.
AI가 더 좋아지면 저절로 풀릴 문제일까요. AI가 나아질수록 흔한 답도 더 그럴듯해집니다. 코드는 더 깔끔해지고 화면은 더 보기 좋아집니다. 그러나 AI가 빈자리를 흔한 답으로 채운다는 사실은 그대로입니다. 학습 데이터만으로는 제 취향이나 이 앱의 목적을 알 수 없습니다. AI가 빈자리에 넣는 것은 학습 데이터에서 얻은 답입니다. 아무리 그럴듯해도 제가 고른 답은 아닙니다.
무엇을 버릴지는 사람이 정한다
AI가 발전할수록 방법이 어느 정도 정해진 일반 작업은 AI에게 맡기게 됩니다. 코드를 쓰거나 화면을 그리고, 글의 초안을 잡거나 자료를 정리하는 일이 그렇습니다. 그 범위가 넓어질수록 앞서 본 수십 개의 빈자리에 어떤 답을 넣을지는 사람이 선택해야 합니다.
선택할 때는 의도와 취향을 기준으로 삼을 수 있습니다. 의도는 무엇을 위해 만드는지 아는 것입니다. 아이 숙제를 챙길 때와 팀의 배포 일정을 관리할 때 필요한 기능은 다릅니다. 취향은 여러 구현 중 어떤 모습과 사용 방식을 선호하는지 고르는 기준입니다. 같은 숙제용 앱이라도 색으로 과목을 구분할지, 글자만 간결하게 보여 줄지는 취향에 따라 달라질 수 있습니다.
선택은 다른 길을 버리는 일이기도 합니다. 마감 기능을 넣지 않으면 화면은 단순해지지만, 마감이 필요한 사람은 이 앱을 쓰기 어렵습니다. 무엇을 버렸고 그 선택 때문에 무엇을 감당해야 하는지는 고른 사람만 압니다. AI는 골라 준 대로 만들 수 있지만, 선택의 대가를 대신 질 수는 없습니다.
다음 작업에도 선택을 남긴다
첫 작업에서는 선택한 조건을 프롬프트에 적습니다. “할 일 앱 만들어줘” 대신 “아이 혼자 휴대폰에서 쓸 숙제용 앱으로 만들어줘. 마감 기능은 빼고, 다 한 일은 다음 날 사라지게 해줘”라고 구체적으로 요청하면 처음 나온 결과가 의도에 가까워집니다.
하지만 프롬프트에만 적은 선택이 다음 작업까지 이어진다고 보장할 수 없습니다. 다음 날 새 작업에서 “설정 화면 추가해줘”라고만 시키면 AI가 전날 적은 “아이 숙제용” 조건을 다시 읽지 못할 수 있습니다. 그러면 설정 화면의 빈자리는 다시 흔한 답으로 채워지고, 어제 고른 것은 오늘 이어지지 않습니다.
사람은 선택이 다음 작업에도 이어지도록 AI가 작업할 때마다 읽을 수 있는 기록을 남겨야 합니다. 아이 숙제용 할 일 앱이라면 “휴대폰 한 화면에 모든 할 일을 보여 준다”, “마감 기능은 넣지 않는다”, “다 한 일은 다음 날 사라진다”처럼 적어 둘 수 있습니다. 왜 그렇게 골랐는지, 어떤 상황이 오면 다시 생각할지도 함께 적습니다. 설정 화면을 만들 때 AI가 이 기록을 먼저 읽으면 처음 고른 방향을 다음 작업에서도 지킬 수 있습니다.
기록은 꼭 문서일 필요가 없습니다. 이미 만든 화면, 좋다고 고른 사례, 용어 목록도 선택을 담은 기록이 됩니다. 중요한 것은 형태가 아니라 AI가 다음 작업에서도 읽을 수 있느냐입니다.
AI도 결과를 봐야 한다
기록은 AI가 따라야 할 방향일 뿐, 결과가 그 방향대로 나왔다는 증거는 아닙니다. AI가 작업을 마쳤다고 말해도 화면이 의도와 다르거나 기능이 제대로 작동하지 않을 수 있습니다. 구현을 맡겼다면 결과를 확인하고 잘못된 부분을 고치는 일도 함께 맡겨야 합니다.
그러려면 사람이 완료 기준을 정하고, AI가 결과를 직접 확인할 수단을 마련해야 합니다.
하나는 일이 끝났다고 판단할 기준입니다. 아이 숙제용 할 일 앱이라면 이렇게 적을 수 있습니다.
- 휴대폰 화면에서 할 일을 추가하고 완료할 수 있다.
- 휴대폰 화면에서 글자가 잘리지 않는다.
- 다 한 일은 다음 날 사라진다.
이 기준은 앞서 정한 취향과 의도에서 나옵니다. 사람이 AI에게 구현을 맡기기 전에 기준을 정하고, AI가 구현할 때와 확인할 때 같은 기준을 쓰도록 함께 전달해야 합니다.
다른 하나는 AI가 결과를 직접 확인할 수단입니다. 사람은 앱을 확인할 때 코드만 읽지 않습니다. 브라우저에서 직접 눌러 보고, 휴대폰에서도 실행해 보며, 문제가 생기면 로그를 확인합니다. AI에게도 같은 수단이 필요합니다.
웹 앱이라면 브라우저를, 휴대폰 앱이라면 시뮬레이터를 AI가 직접 다룰 수 있게 해야 합니다. 로그인해야 하는 앱에는 테스트 계정을 주고, 확인에 필요한 데이터도 넣을 수 있게 합니다. 문제가 생기면 로그와 오류 모니터링 기록도 읽을 수 있어야 합니다.
Anthropic은 오래 걸리는 작업을 AI에게 맡긴 실험에서 이 차이를 보여 줍니다. AI가 브라우저 자동화 도구로 사람처럼 웹 앱을 테스트하자 코드만 읽을 때 놓친 버그를 찾아 고쳤습니다. 반면 자동화 도구가 볼 수 없는 브라우저 알림창을 쓰는 기능에는 버그가 더 많이 남았습니다. AI도 접근할 수 있는 범위까지만 확인할 수 있습니다.
같은 방향은 다른 회사의 도구에서도 보입니다. Anthropic의 Claude Code는 브라우저와 iOS 시뮬레이터를 다룹니다. OpenAI의 Codex는 컴퓨터 화면을 조작하고 앱 안의 브라우저에서 결과를 확인합니다. Google의 Antigravity는 브라우저를 다루고 그 과정을 녹화합니다. 사람이 결과를 확인하던 화면을 AI도 다룬다는 점에서 같습니다.
완료 기준만 있고 확인 수단이 없으면 AI는 코드만 읽고 결과를 추측합니다. 확인 수단만 있고 완료 기준이 없으면 무엇을 확인하고 언제 고쳐야 할지 모릅니다. 둘 다 있어야 AI가 구현한 결과를 직접 확인하고, 기준에 미치지 못하면 고친 뒤 다시 확인할 수 있습니다.
사람이 정하고 AI가 끝낸다
”○○ 앱 만들어줘”라는 말에는 무엇을 만들지, 어떤 결과를 완성된 것으로 볼지, AI가 그 결과를 어떻게 확인할지가 빠져 있습니다. 사람은 방향과 완료 기준을 정하고, AI가 다음 작업에서도 읽을 수 있게 기록합니다. 결과를 직접 확인할 수단도 AI에게 줍니다. 그러면 AI는 구현한 뒤 스스로 확인하고, 기준에 미치지 못하면 고친 뒤 다시 확인할 수 있습니다. AI에게 구현을 맡겼다면 확인하고 고치는 일까지 이어서 맡겨야 합니다.